
A marca d'água que não prova nada
O que o textGrain da OpenAI ensina sobre autoria, prova e responsabilidade
Há uma esperança antiga, e bastante humana, de que a técnica nos dispense de julgar. O selo de cera, o reconhecimento de firma, o carimbo do cartório e, mais recentemente, o certificado digital nasceram todos do mesmo desejo: que um sinal exterior nos diga, sem margem para hesitação, de onde veio um texto e quem responde por ele.
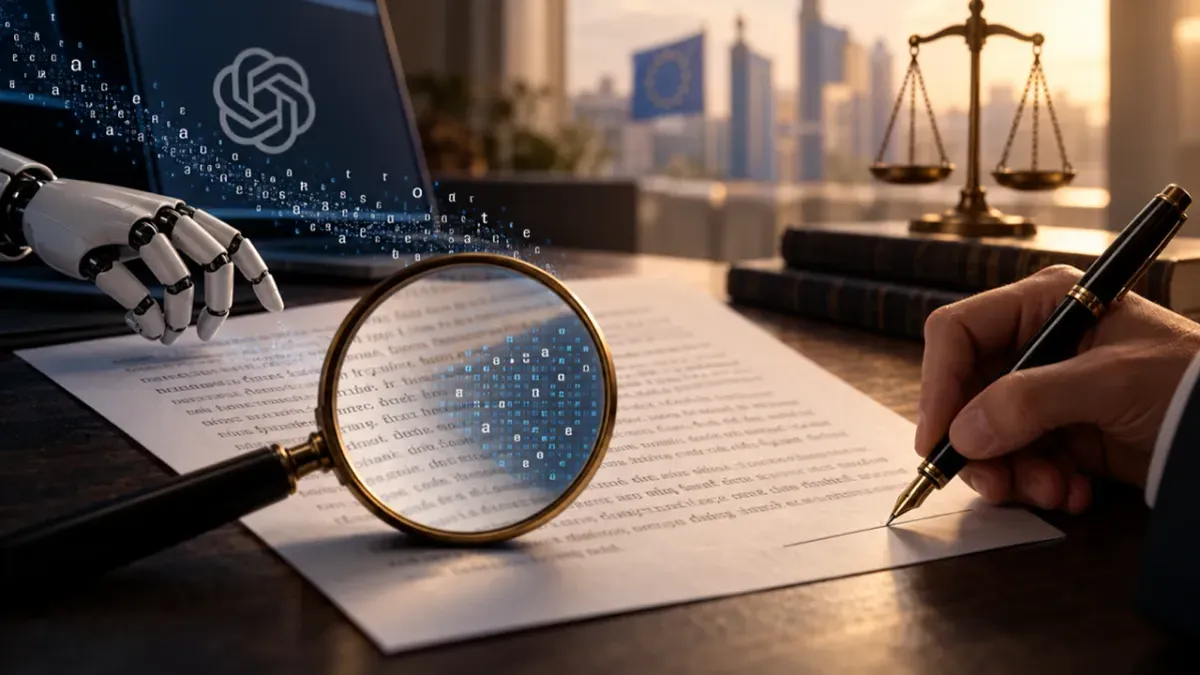
Nesta semana, esse desejo ganhou uma versão estatística. A OpenAI anunciou que os textos produzidos pelo ChatGPT e pelo Codex na União Europeia passarão a carregar uma marca d'água invisível, batizada de textGrain . Nada aparece na página. O sinal está nas escolhas de palavras do modelo, discretamente inclinadas para formar um padrão que só outra máquina consegue reconhecer.
É fácil imaginar o alívio de professores, editores, gestores e de não poucos advogados, como se enfim houvesse um modo de separar o que foi escrito por gente do que foi escrito por máquina. Convém conter o alívio. A marca d'água responde a uma pergunta que o Direito raramente faz e silencia justamente sobre as que ele faz todos os dias.
O que a lei pede e o que preferimos ouvir
O artigo 50 do Regulamento europeu de Inteligência Artificial, aplicável desde 2 de agosto, exige de quem fornece sistemas generativos que o conteúdo sintético seja identificável por máquina, e reserva a quem os utiliza certos deveres de divulgação. O legislador europeu pediu rastreabilidade técnica; não criou, nem pretendeu criar, um regime de prova de autoria.
A distância entre as duas coisas é maior do que parece. Uma norma de conformidade pergunta se a empresa fez o que lhe cabia. Uma regra de prova pergunta se determinado fato pode ser tido por verdadeiro num conflito entre pessoas. O textGrain foi desenhado para a primeira pergunta, e o debate público, com a pressa de sempre, já o convoca para a segunda.
A probabilidade no banco das testemunhas
O mérito da OpenAI, e é justo reconhecê-lo, foi dizer com clareza o que a ferramenta não faz. Num texto de 200 tokens, pouco mais que um parágrafo, o detector encontra a marca em cerca de 80% dos casos; em 400 tokens, em aproximadamente 95%. Basta, porém, trocar uma em cada dez palavras por sinônimos para que o índice caia de 92% para 66%. Qualquer estudante com um dicionário e dez minutos de paciência desfaz o que a engenharia levou anos para construir.
Há ainda o dado que mais deveria nos ocupar: esses números pressupõem 1% de falsos positivos. Um por cento é uma cifra confortável num relatório técnico e desconfortável numa sala de aula, numa banca de concurso ou num processo disciplinar. Em escala, significa pessoas reais acusadas de não terem escrito o que escreveram, e intimadas a produzir a mais ingrata das provas, a de um fato negativo.
E há um equívoco à espreita, dos mais sedutores. Um por cento de falsos positivos não quer dizer que o texto sinalizado tenha 99% de chance de ser obra da máquina. Essa probabilidade depende de quantos textos marcados existem, de fato, no universo examinado: numa turma em que quase ninguém recorreu ao ChatGPT, boa parte dos alarmes soará contra inocentes. Tomar a taxa de erro do instrumento pela culpa provável do indivíduo é um engano velho conhecido dos estatísticos e ainda pouco familiar a quem julga.
O inverso tampouco socorre. A ausência da marca nada diz sobre autoria humana: o texto pode ter saído de outro modelo, ter sido traduzido ou simplesmente editado. E o detector, ao menos por ora, só estará ao alcance de pesquisadores e organizações aprovados pela própria empresa. Temos, portanto, um indício probabilístico, facilmente apagável, cuja verificação depende da boa vontade de quem fabricou o objeto examinado. O artigo 369 do Código de Processo Civil é generoso com os meios de prova, e nada impede que um resultado desses chegue aos autos. O que se discute é o peso: sem contraditório efetivo e sem perícia independente, ele vale pouco, e jamais deveria valer como presunção contra alguém.
Quem assina, responde?
Suponhamos, por generosidade, um detector infalível. Saberíamos com certeza que aquela petição, aquele parecer ou aquele contrato saiu de um modelo de linguagem. E então? A empresa adverte, com razão, que a marca não determina propriedade, legalidade, responsabilidade nem veracidade do conteúdo. Tampouco revela o usuário, a conta ou a conversa de origem. Ela identifica uma máquina e não diz palavra sobre pessoa alguma. Proveniência técnica, autoria intelectual e responsabilidade jurídica são três coisas distintas, e a marca só alcança a primeira.
Quando se trata de responder por um texto, o Direito nunca se interessou muito por quem segurou a pena. Sócios assinam peças redigidas por estagiários, executivos subscrevem relatórios preparados por equipes inteiras, ministros proferem votos minutados por assessores. Fora do campo próprio do direito autoral, o que conta sempre foi um ato de assunção: responde quem apõe o nome e entrega o texto ao mundo como seu. A inteligência artificial deixa essa regra intacta e apenas a torna mais visível, e mais incômoda para quem assina sem ler. O próprio regulamento europeu o admite: dispensa o aviso de que um texto foi gerado por máquina quando alguém o revisou e assume por ele a responsabilidade editorial.
Daí o equívoco de esperar da marca d'água uma espécie de absolvição ou de condenação automática. O advogado que protocola jurisprudência inexistente responde por ela, com ou sem sinal estatístico. O pesquisador responde pelo artigo, a empresa pelo contrato. A pergunta sobre a origem do texto é interessante, mas a que decide o caso continua sendo outra: quem o adotou e com que diligência.
Bruxelas legisla, o Brasil observa
A marca d'água será o padrão apenas para quem estiver na União Europeia. Para os demais, fica disponível pela interface de programação, desligada até que alguém decida ligá-la. O usuário brasileiro do ChatGPT continuará, portanto, a produzir textos sem sinal algum, enquanto a empresa brasileira que atende clientes europeus poderá ver-se instada, por contrato, a ativá-lo. É o conhecido efeito Bruxelas: a norma europeia chega até nós pela via do mercado, sem passar pela do Parlamento.
O nosso próprio marco legal, aprovado pelo Senado em dezembro de 2024, segue em análise numa comissão especial da Câmara dos Deputados, entre sucessivos adiamentos e sem data para votação. Enquanto isso, a matéria vem sendo disciplinada aos pedaços, em normas do Conselho Nacional de Justiça para os tribunais e em recomendações da Ordem para a advocacia. O arranjo tem seus defeitos, mas nos oferece uma vantagem rara, a de assistir à experiência alheia antes de legislar.
Seria um desperdício extrair dela a lição errada. Se viermos a importar a obrigação de marcar, que seja com a consciência de que se trata de um dever de transparência imposto a fornecedores, útil para pesquisa, para moderação de conteúdo, para o combate à desinformação em larga escala. Convertê-la em presunção contra indivíduos seria dar a um cálculo de probabilidades a autoridade que negamos, com boas razões, a testemunhas de carne e osso.
A pergunta que sobra
O textGrain é uma boa peça de engenharia e uma resposta honesta a uma exigência legal. Só não é o que gostaríamos que fosse. Diante da pergunta "esta máquina gerou este texto?", ele oferece uma probabilidade. A pergunta que interessa ao Direito, "quem responde por este texto?", nenhum sinal estatístico responderá por nós.
Para escritórios e empresas, a consequência prática é menos glamourosa do que a tecnologia. Detector nenhum substitui a prova. O uso de inteligência artificial precisa estar previsto nos contratos, e alguém, dentro de casa, precisa saber dizer como a ferramenta foi empregada em cada documento que sai com a assinatura da organização.
Fica, por fim, uma provocação. Passamos os últimos anos perguntando se o texto era da máquina. Talvez fosse mais proveitoso perguntar se quem o assinou sabia o que estava assinando. A marca d'água pode indicar a presença da máquina; a responsabilidade continua sendo de quem decidiu confiar nela. Na sua organização, essa pergunta já tem resposta por escrito?
Publicado originalmente no LinkedIn em 8 de outubro de 2026.
Sobre o autor
Autor
Adriana Cardoso de Moraes Cansian
Advogada